

三代全长微生物多样性测序服务(扩增子)
物种水平精准研究
产品介绍
PRODUCT INTRODUCTION三代全长微生物多样性测序(PacBio SMRT)
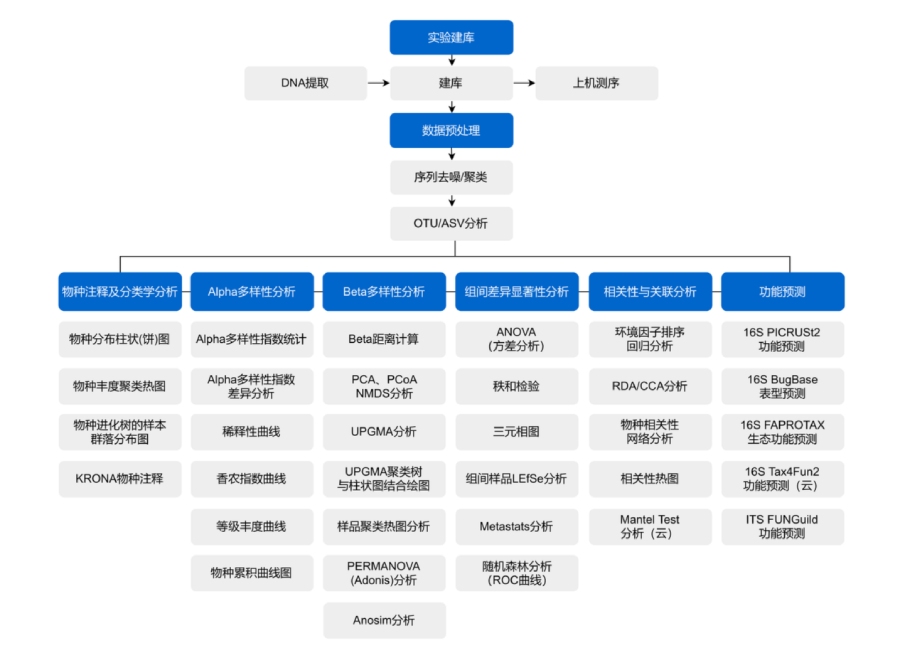
三代全长微生物多样性测序(扩增子测序)是基于 PacBio 测序平台,利用单分子实时测序(SMRT Cell)的方法对 marker 基因进行测序,之后通过对 CCS(Circular Consensus Sequencing)序列过滤,得到 Optimization-CCS 进行 OTUs(Operational Taxonomic Units)聚类,并进行物种注释及丰度分析,可以揭示样品的物种构成;进一步进行 α 多样性分析(Alpha Diversity)、β 多样性分析(Beta Diversity)和显著物种差异分析等,可以挖掘样品之间的差异。
目前,微生物多样性研究主要针对编码核糖体 RNA 的核酸序列保守区进行:细菌主要基于 16S 区,真菌主要基于 18S 区或 ITS 区(内转录间区)。16S rDNA 是编码原核生物核糖体小亚基 rRNA(16S rRNA)的 DNA 序列,18S rDNA 是编码真核生物核糖体小亚基 rRNA(18S rRNA)的 DNA 序列,ITS 是其内转录间隔区序列。这些序列中既有保守区又有可变区,保守序列区域反映了生物物种间的亲缘关系,而高变序列区域则能体现物种间的差异。由于 ITS 区进化速率约为 18S rDNA 的 10 倍,属于中度保守区域,利用它可研究种及种以下的分类阶元。
产品优势
- 提高物种注释准确性和分辨率:与 16S 部分区域的扩增和测序相比,PacBio 全长 16S 扩增子测序对 16S rRNA 基因的全长序列进行扩增和测序,一方面可以显著提高注释物种的准确性,另一方面可以提高物种注释的分辨率,实现"种"水平的物种注释。
- 无样品和物种偏好性:全长 16S 扩增子测序由于是对 16S rRNA 基因的全长序列进行测序,具有更广泛的样品和物种适用性,避免了常规扩增子测序的不同测序区域带来的对不同样品来源和物种的偏好。
- 全自动化产线平台:百迈客斥资 4000 万打造全自动化实验平台百灵 2000,已执行样品 30 万+,大大提升实验数据的准确性、时效性和均一性,提取成功率 99% 以上。
- 云流程操作便捷:BMKCloud 云平台兼容二三代,支持 ASV 和 OTU 两种数据方式可选,支持个性化分析与交互式分析,配色、字体等自定义修改。
结果展示
ANALYSIS RESULTS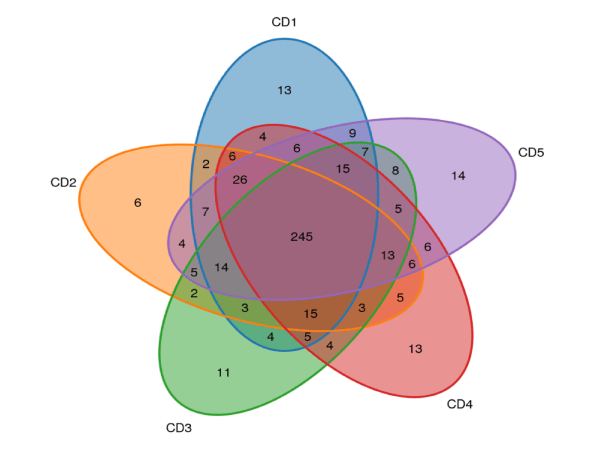
OTU/ASV 分析(Venn 图)
利用 Venn 图可以展示样品(数目 2 到 5)之间共有、特有特征数目,直观地表现出样品间特征的重合情况。结合特征所代表的物种,可以找出不同环境中的共有微生物。
物种分布柱状(饼)图
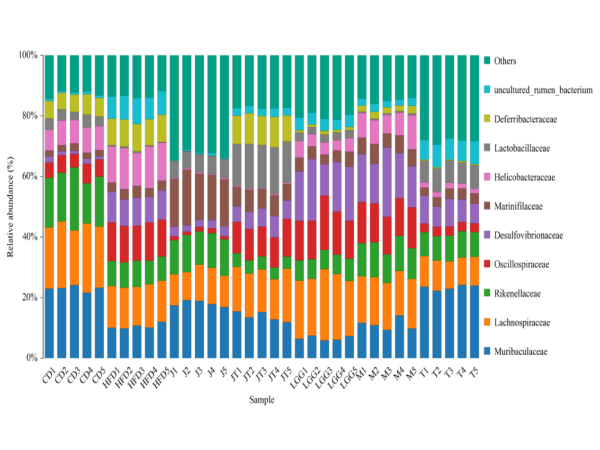
各水平物种分布柱状(饼)图:从左至右依次为门、纲、目、科、属、种水平;一种颜色代表一个物种,色块长度(柱状图)或色块面积(饼图)表示物种所占相对丰度比例。
丰度热图
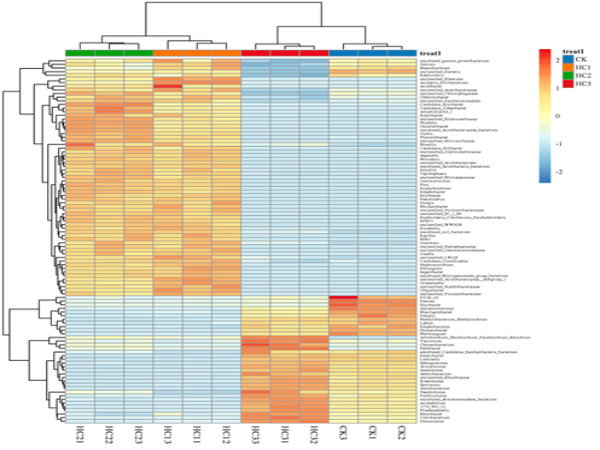
丰度热图是以颜色梯度来代表数据矩阵中数值的大小,并根据物种 / 功能或样品丰度相似性进行聚类的一种图形展示方式。
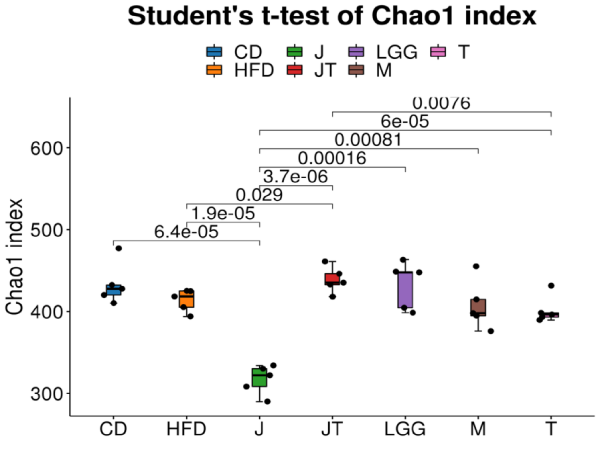
Alpha 多样性指数差异分析
对于有分组的样本(每组样本数 ≥3),可使用 R 脚本将数据绘制成箱线图,以直观地展示不同样本组之间的 alpha 多样性差异,默认通过 Student t 检验,验证差异的显著性。
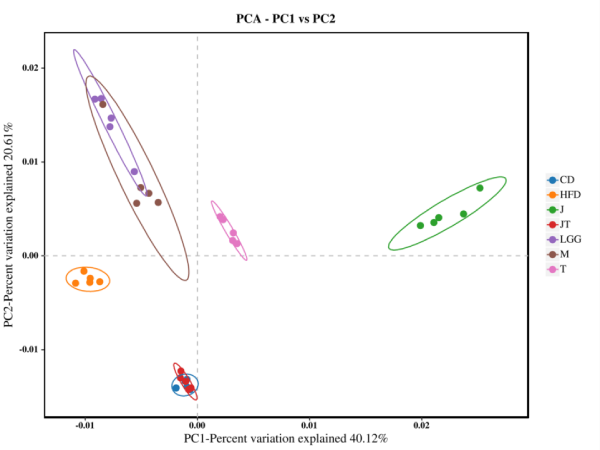
主成分分析(PCA)
主成分分析(Principal Component Analysis, PCA)是一种分析和简化数据集的技术,通过将方差进行分解,将多组数据的差异反映在二维坐标图上。PCA 图上两个样品距离越近,则表示这两个样品中物种的组成越相似。使用 R 语言工具分别绘制种分类水平 PCA 分析图。
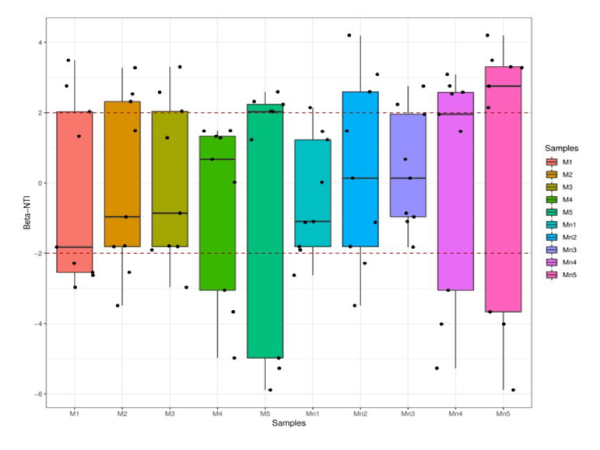
群落结构分析
分析样本间的群落结构变化是由确定性过程主导,还是随机性过程主导。
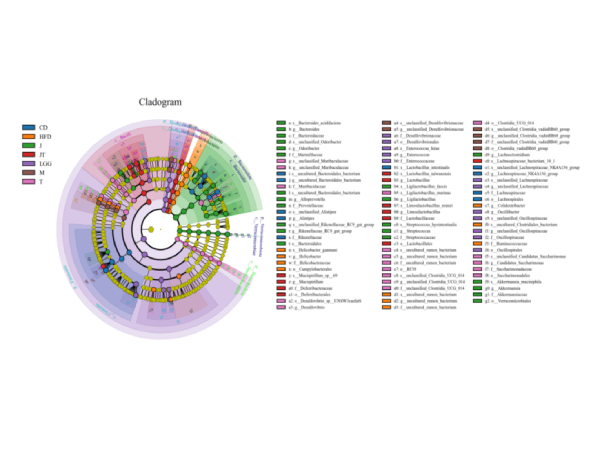
LEfSe 分析
LEfSe 分析用于两个或者多个分组之间的比较,同时也可实现分组内的亚组之间的比较,从而在不同分组间寻找具有统计学差异的 biomarker。
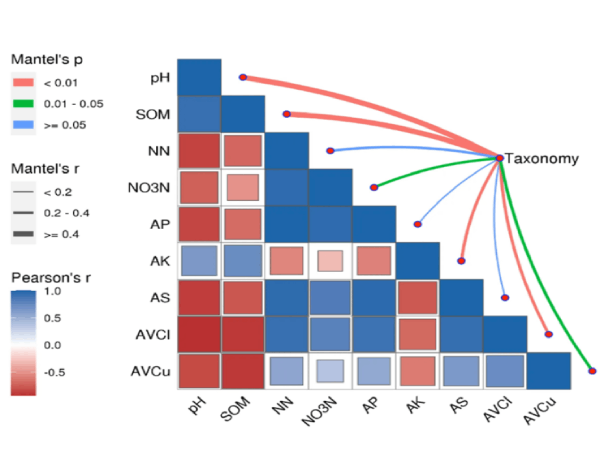
Mantel test 分析
Mantel test 是检验两个矩阵相关关系的非参数统计方法,多用在生态学上,用来检验群落距离矩阵和环境变量距离矩阵之间的相关性。
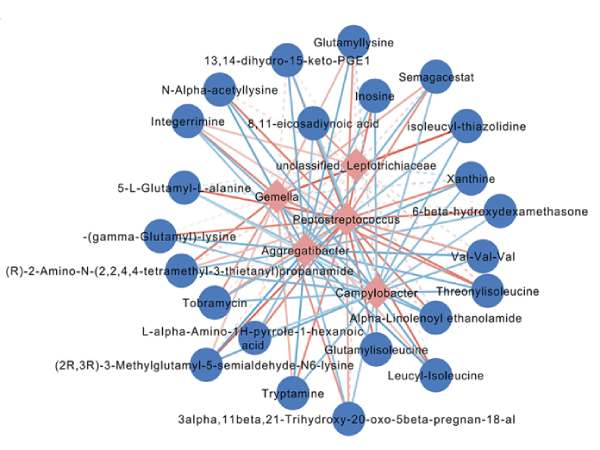
相关性网络图分析(Cytoscape)
网络图可以直观地体现物种 / 功能分类水平在所选择样品之间含有的相关性关系。通过计算网络的节点度分布、网络的直径、网络的平均最短路径,以及节点联通性、紧密系数、介数中心性等属性,来获得物种与物种或功能与功能的组内或组间的相关信息,更加全面高效地挖掘出复杂数据中包含的信息。
送样指导
SAMPLING GUIDE| 组织类型 | 微生物多样性 | 微生物多样性绝对定量 Q-MCD |
|---|---|---|
| 土壤 | 1~2 g | 1~2 g |
| 淤泥 | 1~2 g | 1~2 g |
| 动物肠道内容物 | 0.5~2 g | 0.5~2 g |
| 昆虫肠道内容物 | 0.1~0.25 g | 0.25~0.5 g |
| 植物表面 | 富集沉淀物 0.1~0.5 g | 不建议送(送前先沟通进行评估) |
| 粪便(大型动物) | 0.5~2 g | 0.5~2 g |
| 粪便(成鼠) | 3-5 粒 | 3-5 粒 |
| 肺泡灌洗液(鼠等) | 滤纸 | 不建议送 (送前先沟通进行评估) |
| 阴道拭子 | 拭子 5-6 个 | |
| 物体表面微生物 | 滤膜或拭子 | |
| 水体 | 滤纸 | |
| 空气样本 | 滤纸 | |
| 生物膜 | 滤纸 | |
| 植物内生菌 | 1-2 g | |
| 牙斑菌 | 0.5-1 g | |
| 皮肤样本 | 拭子 2-3 个 | |
| 生殖道拭子 | 拭子 2-3 个 | |
| 发酵液 | 富集沉淀物 0.1-0.5 g | |
| 唾液 | 拭子 2-3 个 | |
| 口腔软组织 | 拭子 2-3 个 | |
| 咽部拭子 | 拭子 2-3 个 | |
| 直肠拭子 | 拭子 2-3 个 |
应用领域
APPLICATION FIELDS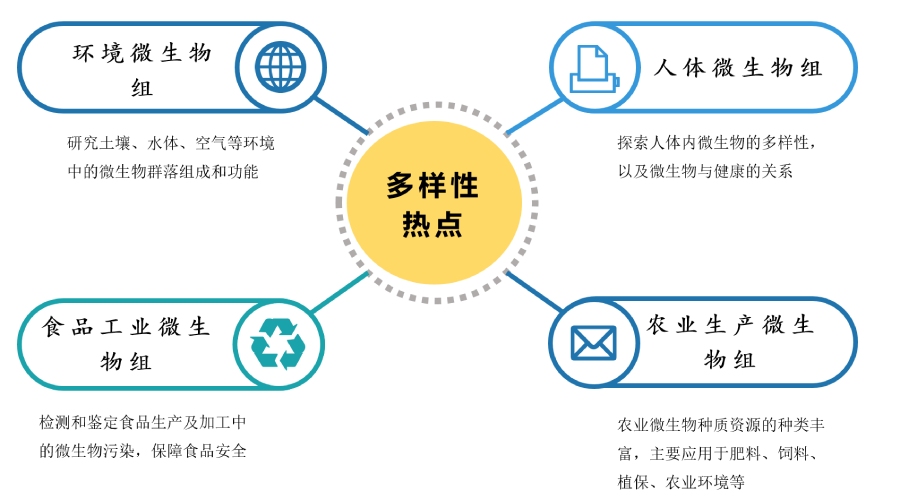
常见问题
FAQQ1 客户做菌种鉴定,如何推荐?
全长 16S 长度为 1.5kb 左右,单菌落的 16S 全长 Sanger 一代测序是菌种鉴定的主要手段;纳米孔和 PacBio 的三代测序可以高通量地获得全长序列,但成本较高、周期较长。建议客户单菌使用一代 Sanger 测序。
Q2 16S 就可能预测基因和功能吗?
16S 序列能够区分菌的种属,但并不包含这些菌的基因和代谢功能的信息。我们已对大量细菌基因组进行了测序,所以可以根据 16S 的菌种信息,来预测菌群的功能基因分布和代谢途径分布情况。
目前主要使用的软件是 PICRUSt 和 Tax4Fun(百迈客云支持):PICRUSt 适合肠道环境样本,Tax4Fun 适合水体、土壤等环境样本。肠道菌群、土壤以及一些致病菌的测序较多,预测准确度可达 85-90% 以上;一些海洋的菌由于测序的菌较少,预测准确性要差一些。目前发表的文献基本都是用 PICRUSt。
Q3 内生菌可以做全长多样性吗?
目前内生菌引物为规避线粒体和叶绿体,对引物序列进行了调整,但仅针对二代引物;全长引物无法避免扩增到宿主序列。
Q4 宏基因组与微生物多样性的区别?
宏基因组将基因组 DNA 随机打断成若干条小片段,然后在片段两端加通用引物进行 PCR 扩增测序,将得到的 reads 进行组装后进行基因预测得到基因序列,众多基因构成环境中微生物的基因集。
微生物多样性主要针对核糖体小亚基基因序列进行测序(16S rDNA 或者 18S rDNA),通过特异性引物对某一段或某几段高变区(如 V3-V4 区)进行扩增测序,然后与数据库比对,可特异性识别细菌种类。总的来说,微生物多样性主要告诉我们环境里有什么微生物,而宏基因组主要告诉我们环境里的微生物能做什么。
Q5 为什么宏基因组与微生物多样性物种注释结果存在差异?
微生物多样性和宏基因组都会分析环境中物种的种类,但物种的丰度在二者之间存在一定的差异。第一种原因是微生物多样性是基于核糖体小亚基基因序列进行物种注释和丰度统计,而不同物种中核糖体基因的拷贝数不一样,这会带来一些误差;第二种原因是二者在建库测序过程中会进行 PCR 反应,在 PCR 过程中也会存在一些误差。
CUSTOM RESEARCH PLAN
获取三代全长多样性专属研究设计方案
告诉我们您的研究目标与样本类型,百迈客技术团队将为您定制测序与分析方案
获取设计方案方案咨询 · 送样安排 · 售后支持
为世界创造新的可能
Copyright All Rights Reserved © 2026 北京百迈客生物科技有限公司 京ICP备10042835号-2  京公网安备11011302003368号